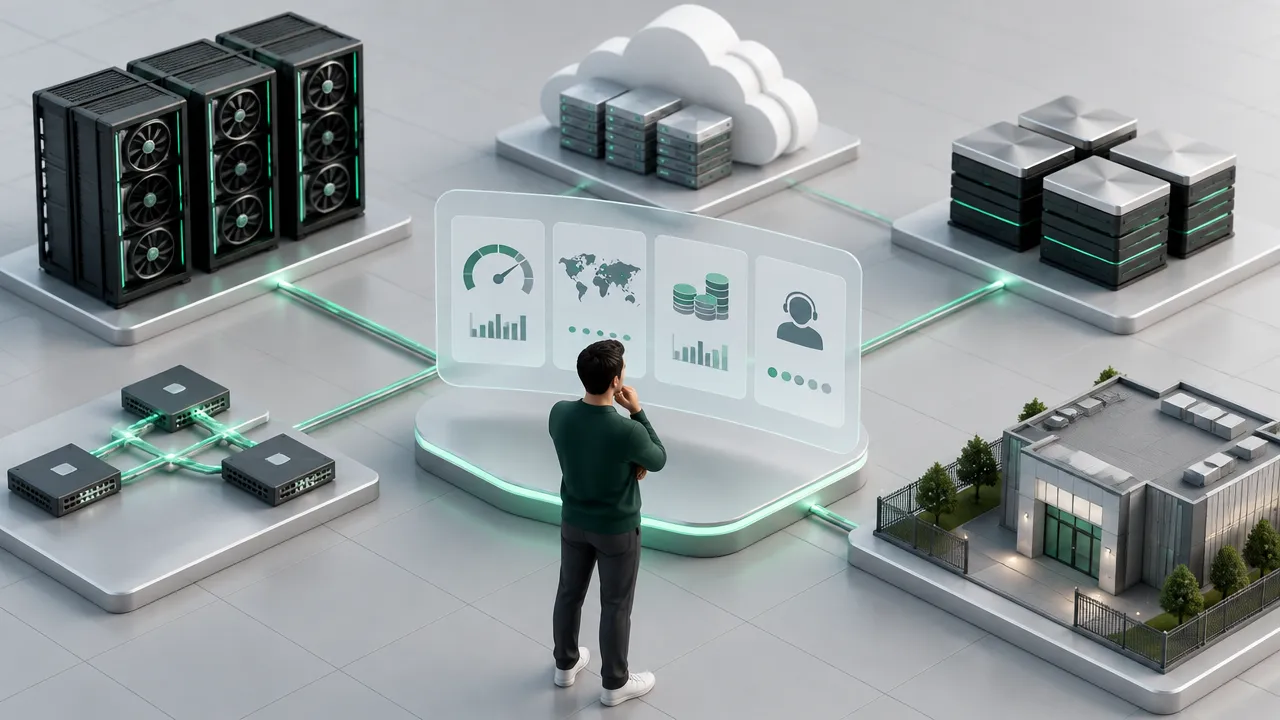
Provedores de infraestrutura de IA devem ser comparados pela capacidade de suportar uma carga de trabalho de produção específica, e não por um ranking genérico. Para bancos, fintechs e outras organizações reguladas, a decisão também depende da localização dos dados, do suporte operacional, da aderência da plataforma e do custo total de rodar os modelos.
Uma comparação útil começa pela camada de infraestrutura que cada provedor oferece e, em seguida, a testa contra os requisitos reais da carga de trabalho. Essa abordagem ajuda os times a montar uma shortlist de opções capazes de atender às necessidades de desempenho, governança e orçamento.
Pontos-chave para avaliar provedores
- Compare opções equivalentes: hardware, capacidade em nuvem, software de orquestração e serviços gerenciados resolvem problemas diferentes.
- Teste cargas de trabalho representativas de produção, em vez de confiar em especificações de destaque ou benchmarks sem relação com o seu caso.
- Verifique onde dados, logs, backups e acessos operacionais são tratados, e não apenas onde fica o servidor principal.
- Calcule o custo total considerando computação, armazenamento, rede, capacidade ociosa, suporte e condições de cobrança.
- Confirme se o provedor consegue apoiar deploy, monitoramento, resposta a incidentes e escalabilidade futura.
Comece identificando a camada de infraestrutura de cada provedor
A infraestrutura de IA abrange a computação, o armazenamento, a rede e o software necessários para treinar ou servir modelos. As empresas podem fornecer uma única camada ou combinar várias, por isso uma shortlist só faz sentido quando as opções cumprem papéis comparáveis.
| Modelo de provedor | O que normalmente fornece | Pergunta útil para comparação |
|---|---|---|
| Infraestrutura de computação | Servidores com GPU ou máquinas virtuais | O hardware consegue rodar o modelo-alvo na escala necessária? |
| Plataforma de GPU gerenciada | Capacidade de GPU com orquestração e suporte operacional | Quanto da configuração e manutenção do cluster continua com o cliente? |
| Data center ou serviço de colocation | Instalações, energia, refrigeração e conectividade física | Quem gerencia os servidores, a plataforma e as falhas? |
| Camada de software e orquestração | Ferramentas de agendamento, deploy, monitoramento ou model serving | Funciona com a stack atual da organização? |
| Serviço de infraestrutura integrado | Uma combinação de computação, plataforma e suporte | As responsabilidades e os limites do serviço estão claros? |
Essa distinção é importante porque o maior operador de infraestrutura não é automaticamente o provedor certo para uma carga de trabalho específica. Um time que busca inferência gerenciada, por exemplo, pode valorizar mais a operação de Kubernetes e o suporte a incidentes do que o acesso a um grande catálogo de nuvem de uso geral.
Teste a plataforma com uma carga de trabalho representativa
Um teste curto com a carga de trabalho real oferece uma comparação mais útil do que uma ficha técnica. Use o modelo pretendido, o framework de serving, o padrão de requisições e o formato dos dados e, depois, registre os resultados sob demanda estável e de pico.
Meça latência de resposta, throughput, tempo de inicialização, utilização de GPU e comportamento durante falhas ou picos de tráfego. Mantenha consistentes entre os provedores as versões dos modelos, o tamanho das requisições, a concorrência e a duração do teste. Caso contrário, o benchmark pode refletir condições de teste diferentes, e não uma diferença real de infraestrutura.
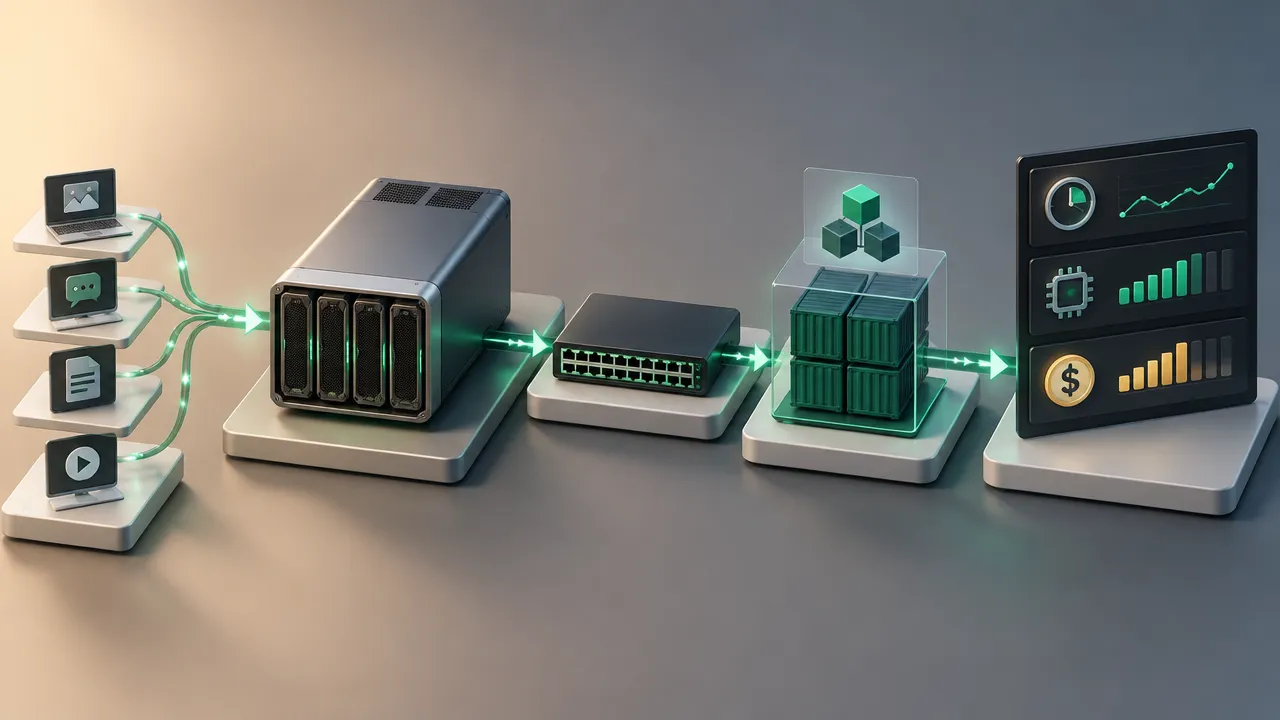
Inclua o caminho operacional, e não apenas a capacidade bruta de computação. Times que fazem deploy de IA generativa ou de agentes devem testar como a plataforma lida com requisições paralelas, retentativas, tarefas de longa duração e os serviços de apoio de que essas cargas precisam.
Verifique a localização dos dados, os acessos e as responsabilidades de compliance
Para cargas de trabalho reguladas, a residência de dados exige mais do que checar a localização do servidor de GPU principal. Revise onde prompts, saídas, logs, backups, telemetria e registros de suporte são armazenados, e quem pode acessá-los durante a operação normal e a resposta a incidentes.
A ANPD estabelece regras para transferências internacionais de dados pessoais, incluindo mecanismos como decisões de adequação e salvaguardas contratuais. O regulamento da ANPD sobre transferência internacional é uma referência útil quando os times mapeiam fluxos de dados e responsabilidades. Um local de processamento no Brasil pode apoiar uma estratégia de soberania, mas as organizações ainda precisam avaliar as transferências que de fato ocorrem e sua base legal.
Peça a cada provedor que documente os caminhos dos dados, suboperadores, locais de backup, controles de acesso, retenção e processos de exclusão. Esses detalhes ajudam os times jurídico, de segurança e de infraestrutura a avaliar os riscos em conjunto, em vez de tratar o compliance como um item a ser marcado no fim da contratação.
Compare a plataforma e seu modelo de operação
A infraestrutura de produção inclui as ferramentas e as pessoas necessárias para manter as cargas de trabalho disponíveis. Compare compatibilidade com Kubernetes, agendamento de GPUs, fluxos de deploy, monitoramento, escalabilidade de capacidade e o processo de resolução de incidentes.
Os times também devem definir quem é responsável por cada tarefa operacional. Um provedor pode fornecer a computação enquanto o cliente cuida de upgrades do cluster, model serving, configuração de segurança e plantão. Um serviço gerenciado pode assumir mais desse trabalho, mas o contrato deve deixar esse limite explícito.
A governança pode fazer parte da mesma análise. O NIST AI Risk Management Framework, de adesão voluntária, organiza o trabalho de gestão de riscos em funções como mapear, medir e gerenciar. Times de infraestrutura podem usar essas categorias para estruturar perguntas sobre o contexto da carga de trabalho, o monitoramento e a resposta a riscos.
Calcule o custo total da carga de trabalho, não apenas a hora de GPU
O preço por hora de GPU é apenas uma parte do custo de infraestrutura. Uma estimativa realista deve incluir armazenamento, rede, transferência de dados, capacidade ociosa, orquestração, suporte, compromissos mínimos, moeda de cobrança e tributos aplicáveis.
Modele a carga de trabalho esperada ao longo de um mês normal, incluindo testes de deploy, períodos de baixa e picos de demanda. Pergunte se a capacidade pode ser reduzida quando não for necessária, se a cobrança é granular e se a transferência de dados pela rede gera cobranças adicionais. Comparar a mesma carga de trabalho e o mesmo período de cobrança deixa os trade-offs financeiros mais claros.
A Nuplia oferece capacidade de GPU elástica e cobrada por hora no Brasil, incluindo GPUs RTX PRO 6000 Blackwell para inferência e fine-tuning, com Kubernetes e orquestração de GPUs. O serviço também inclui suporte contratual em português, faturamento em reais com NF-e e zero taxa de egress, o que pode facilitar a avaliação desses custos e condições operacionais na comparação entre provedores.
Use um scorecard consistente antes de decidir
Um scorecard ajuda as áreas de compras, engenharia, segurança e finanças a avaliar as mesmas evidências. Pontue cada opção da shortlist de acordo com os requisitos da organização e registre a comprovação por trás de cada nota, em vez de depender de apresentações comerciais.
| Área de avaliação | Evidência a solicitar |
|---|---|
| Aderência à carga de trabalho | Resultados de um teste reproduzível com o modelo e o padrão de tráfego pretendidos |
| Controle dos dados | Locais e regras de acesso documentados para dados, logs, backups e telemetria |
| Operação da plataforma | Responsabilidade clara por orquestração, upgrades, monitoramento e incidentes |
| Previsibilidade de custos | Estimativa da fatura mensal com premissas de uso e todos os tipos relevantes de cobrança |
| Prontidão do serviço | Canais de suporte, etapas de escalonamento, compromissos de serviço e termos contratuais |
A melhor escolha é o provedor que atende aos requisitos técnicos e de governança da carga de trabalho com um modelo de operação que a organização consiga sustentar. Revise a comparação sempre que modelos, tráfego, regulação ou necessidades de deploy mudarem, porque essas mudanças podem alterar tanto o custo quanto o risco.