Workloads de IA regulados precisam de uma infraestrutura projetada em torno da movimentação de dados, das fronteiras de acesso, das evidências operacionais e da recuperação, e não apenas da capacidade de GPU. Um stack de infraestrutura de IA bem projetado conecta cada workload em produção a controles que a organização consegue testar e documentar. Para bancos, fintechs e outras empresas reguladas no Brasil, isso também significa decidir onde os dados são processados e como as responsabilidades do provedor se encaixam na governança existente.
Principais decisões de design para IA regulada
- Mapeie todos os fluxos de dados, incluindo prompts, logs, embeddings, backups e acesso do suporte.
- Ajuste a capacidade de GPU e o desempenho do armazenamento ao workload real do modelo.
- Use orquestração para aplicar políticas de isolamento, acesso e recursos de forma consistente.
- Defina requisitos de evidências, resposta a incidentes e recuperação antes da produção.
- Meça custo e qualidade de serviço por workload concluído, e não apenas por hora de GPU.
Comece pelo workload e por sua fronteira de dados
A primeira decisão de design é quais dados a aplicação processa e por onde cada parte desses dados trafega. Um modelo de atendimento ao cliente, por exemplo, pode receber informações pessoais nos prompts, consultar registros internos, gerar embeddings e gravar logs de requisições. São fluxos distintos, com requisitos diferentes de acesso, retenção e localização.
As equipes devem mapear o caminho do sistema de origem até o modelo e de volta, incluindo backups, ferramentas de monitoramento e suporte humano. Com isso, podem classificar os dados, identificar quem tem acesso a eles e especificar onde o processamento e o armazenamento são permitidos. Manter computação e dados no Brasil pode reduzir a exposição transfronteiriça, mas a localização, por si só, não garante conformidade com a LGPD.
O regulamento de transferência internacional da ANPD estabelece condições e mecanismos válidos para transferências de dados pessoais. Por isso, o design deve registrar se ocorre uma transferência e qual mecanismo legal se aplica, em vez de tratar toda transferência como automaticamente proibida ou automaticamente em conformidade.
Construa o stack em torno de seis camadas operacionais
Um stack de produção funciona quando cada camada tem um responsável, uma fronteira e um controle testável bem definidos. A visão a seguir conecta os componentes técnicos às evidências de que as equipes de risco e de plataforma precisam.
| Camada | Foco de design | Evidências úteis |
|---|---|---|
| Workload | Modelo, tarefa, usuários e ações permitidas | Caso de uso aprovado e política de acesso |
| Dados | Fontes, armazenamento, retenção e movimentação | Mapa de fluxo de dados e regras de retenção |
| Computação | GPU, CPU, memória e capacidade | Registros de benchmark e de capacidade |
| Orquestração | Agendamento, isolamento e deploy | Configuração e histórico de deploys |
| Segurança | Identidade, segredos, rede e criptografia | Revisões de acesso e testes de segurança |
| Operações | Monitoramento, incidentes e recuperação | Alertas, registros de incidentes e testes de recuperação |
Essa estrutura também ajuda as equipes a comparar provedores de infraestrutura com base em requisitos concretos: geografia do deploy, isolamento de workloads, termos contratuais, acesso do suporte e capacidade de recuperação. Um checklist de provedores é mais útil quando cada item está vinculado a um controle ou artefato de evidência, e não a uma alegação genérica de segurança.
Dimensione a capacidade de GPU pelo comportamento real do modelo
A escolha de GPU deve seguir as necessidades medidas do workload, e não apenas o tamanho do modelo. Tráfego de inferência, jobs de fine-tuning e fluxos com agentes impõem demandas diferentes de memória, concorrência, throughput de armazenamento e tempo de resposta. Um agente que chama ferramentas repetidamente, por exemplo, pode gerar um padrão de requisições diferente de uma interface de chat com resposta única.
Antes de escolher a capacidade, as equipes devem fazer benchmarks com entradas representativas e a concorrência esperada. Devem registrar latência de resposta, throughput, uso de memória, tempo de fila e comportamento de falha sob carga. Esses testes revelam se o gargalo está na memória da GPU, no pré-processamento em CPU, na leitura do armazenamento ou no próprio tratamento de requisições da aplicação.
O dimensionamento para produção também deve incluir uma política de capacidade. As equipes podem definir quando os workloads entram em fila, quando capacidade adicional de GPU é provisionada e como jobs não urgentes cedem lugar à inferência voltada ao cliente. Isso evita reservar aceleradores caros para workloads que não precisam de execução imediata, ao mesmo tempo que protege os níveis de serviço das requisições críticas.
Use Kubernetes para tornar as fronteiras dos workloads replicáveis
O Kubernetes pode oferecer um control plane consistente para fazer deploy de modelos e alocar recursos de GPU, desde que o cluster esteja configurado para expor e governar esses dispositivos corretamente. Seu framework de device plugins permite que recursos específicos de fornecedores, como GPUs, sejam anunciados ao kubelet para agendamento.
Para workloads regulados, o agendamento de GPU é apenas uma parte do design. As equipes devem definir fronteiras de namespaces e service accounts, controle de acesso baseado em funções, network policies, gestão de segredos, resource quotas e aprovações de deploy. Esses controles devem ser testados contra os caminhos reais entre a aplicação, o servidor do modelo, os repositórios de dados e os sistemas de monitoramento.
Artefatos de modelo e mudanças de configuração também precisam de rastreabilidade. Deploys versionados, acesso controlado a registros de modelos e procedimentos de rollback ajudam as equipes a identificar o que mudou quando as saídas ou o desempenho se alteram. Em aplicações baseadas em agentes, as permissões de ferramentas devem ser separadas do acesso ao modelo, para que uma resposta gerada não ganhe automaticamente autoridade para executar ações sensíveis.
Faça de conformidade, auditoria e recuperação parte da arquitetura
Requisitos regulatórios e contratuais devem moldar o design do serviço antes de os workloads entrarem em produção. Para as instituições dentro de seu escopo, a Resolução CMN nº 4.893 trata da contratação de serviços relevantes de processamento e armazenamento de dados e de computação em nuvem, incluindo os países e regiões onde os serviços e os dados podem estar localizados, segregação de dados, segurança, incidentes e continuidade.
Isso torna a documentação do provedor e da plataforma operacionalmente importante. Contratos e runbooks devem esclarecer locais permitidos, acesso do suporte, notificação de incidentes, devolução ou exclusão de dados, procedimentos em caso de interrupção do serviço e como a organização pode restaurar ou migrar seu workload. Os planos de recuperação devem especificar objetivos de recuperação testados e dependências, incluindo arquivos de modelo, imagens de contêiner, credenciais e dados de origem.
Um framework de risco pode ajudar a conectar os controles técnicos a responsáveis e revisões. O NIST descreve seu AI Risk Management Framework como um recurso voluntário para gerenciar riscos de IA, incluindo riscos específicos de IA generativa. As equipes podem usá-lo como referência de planejamento junto às obrigações legais brasileiras e setoriais, e não como substituto delas.
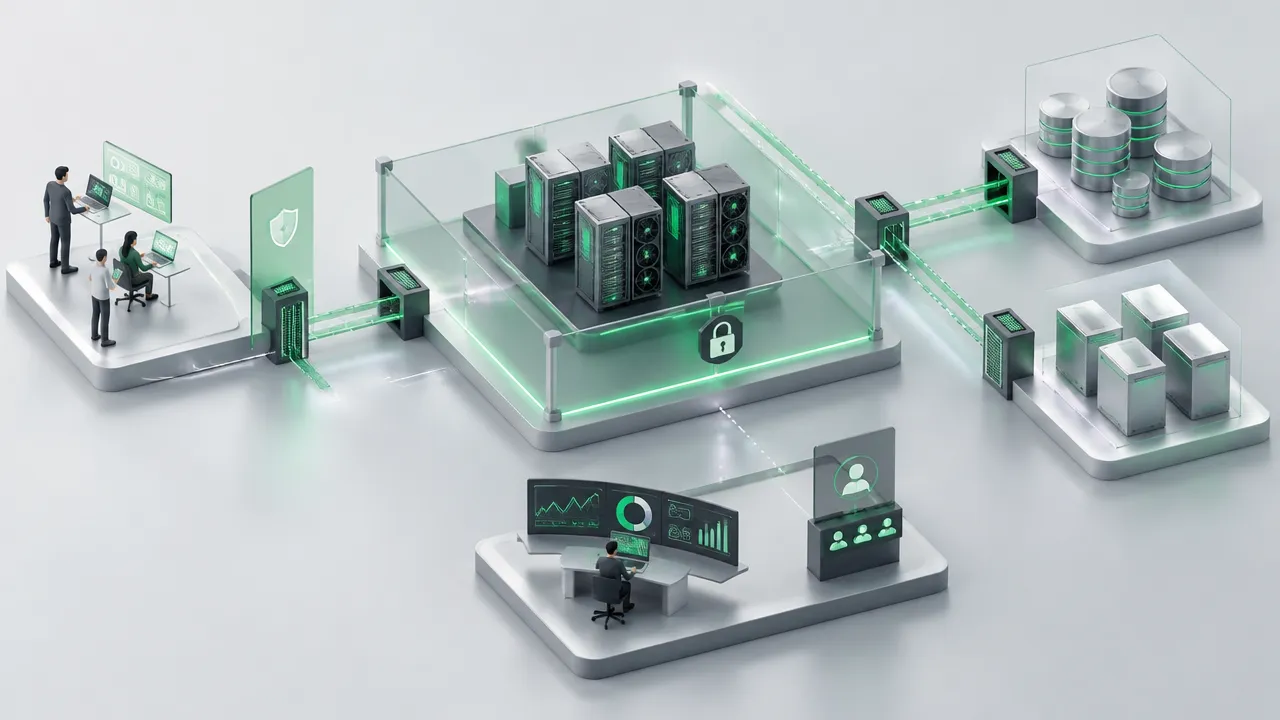
Acompanhe qualidade de serviço e custo no nível do workload
Um modelo operacional útil mede se cada workload atende a seus objetivos de serviço e de governança. As equipes devem monitorar latência das requisições, profundidade de fila, taxas de erro, utilização de GPU, disponibilidade de capacidade e a saúde dos serviços de dados dependentes. Também devem definir quem recebe os alertas e quais ações são tomadas quando um limite é ultrapassado.
A análise de custo deve ir além do preço da GPU. Armazenamento, movimentação de dados, capacidade ociosa, suporte e arranjos de recuperação podem afetar o custo total de um serviço em produção. Medir o custo por requisição bem-sucedida ou por lote concluído facilita a comparação entre opções de deploy e a definição de orçamentos à medida que o uso muda.
Para workloads brasileiros, a moeda de faturamento, a documentação fiscal, a localização dos dados e os termos de egress também podem afetar compras e operações. A Nuplia oferece GPU-as-a-Service gerenciado no Brasil, com capacidade elástica de GPUs NVIDIA cobrada por hora, incluindo GPUs RTX PRO 6000 Blackwell, Kubernetes e orquestração de GPU, suporte contratual em português, faturamento em reais com NF-e e zero taxa de egress. Esses recursos podem ser avaliados em relação aos requisitos técnicos e de governança do workload.
Lance com um caminho controlado para produção
Um rollout em etapas expõe lacunas de design antes que um modelo se torne uma dependência crítica. Um piloto deve usar dados e tráfego representativos, aplicar as fronteiras de segurança pretendidas e exercitar os procedimentos de monitoramento e recuperação. As equipes devem registrar uma linha de base de desempenho e custo, para que mudanças posteriores possam ser avaliadas em relação a um estado operacional conhecido.
- Documente o caso de uso, as classes de dados e os locais aprovados.
- Faça benchmarks do modelo com entradas e concorrência representativas.
- Teste os controles de isolamento de identidade, rede, armazenamento e GPU.
- Realize exercícios de incidente, rollback e recuperação.
- Revise evidências do serviço, custo e responsabilidades antes de ampliar o tráfego.
Essa abordagem dá às equipes de engenharia, segurança, compliance e compras uma base comum para a tomada de decisões. O stack de infraestrutura de IA resultante é mais fácil de auditar e adaptar, porque suas fronteiras, dependências e evidências operacionais são projetadas junto com a aplicação.