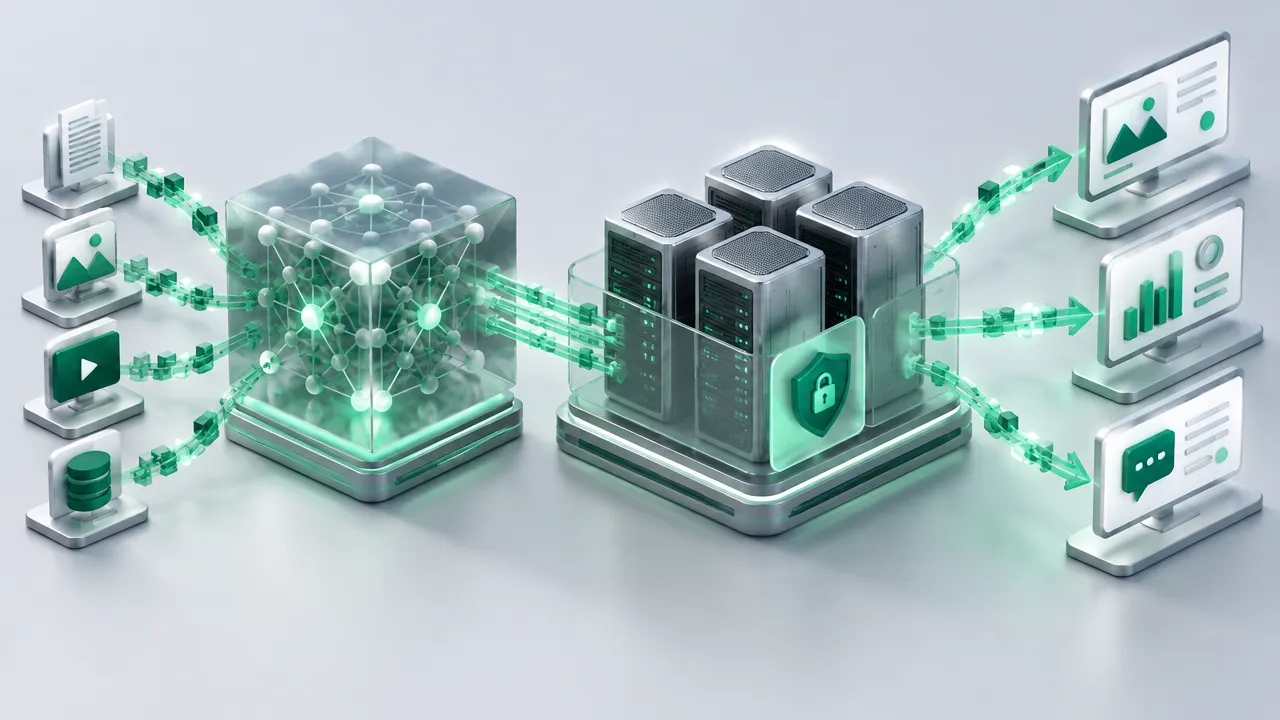
Inferência de IA é o processo de usar um modelo treinado para produzir um resultado a partir de uma nova entrada. É a parte de um sistema de IA com a qual usuários e aplicações de negócio interagem: um score de risco, uma classificação, uma previsão ou uma resposta gerada. Para equipes que estão levando IA para produção, entender inferência significa entender tanto como um modelo é executado quanto qual infraestrutura mantém seus resultados úteis, responsivos e sob governança.
Pontos-chave sobre inferência de IA
- A inferência aplica os parâmetros aprendidos de um modelo a novos dados; ela não atualiza esses parâmetros.
- Modelos tradicionais costumam retornar um score ou rótulo, enquanto modelos generativos produzem conteúdo passo a passo.
- O desempenho em produção depende de todo o caminho da requisição, incluindo processamento da entrada, execução do modelo, software de serving e monitoramento.
- Latência, throughput, qualidade dos resultados, custo e controles de dados devem ser avaliados em conjunto.
- Em cargas de trabalho reguladas, onde os dados são processados e quem pode acessá-los fazem parte da decisão de deploy.
O que significa inferência em IA?
Inferência é o uso, por um modelo, de padrões aprendidos para fazer uma previsão ou gerar um resultado a partir dos dados que recebe. A entrada pode ser o registro de uma transação, um documento, uma imagem ou um prompt. O resultado pode ser um score de risco de fraude, uma categoria, uma previsão ou uma resposta em linguagem natural.
Um modelo sozinho não é uma aplicação completa. Um sistema em produção também precisa de uma forma de receber requisições, preparar entradas, executar o modelo, retornar resultados e tratar falhas. Esse processo mais amplo é o motivo pelo qual a inferência costuma ser discutida tanto como computação quanto como carga de trabalho de serving.
Por exemplo, um banco pode enviar determinadas características de uma transação a um modelo de fraude durante um fluxo de autorização. O modelo retorna um score de risco, que a aplicação pode combinar com suas próprias regras ou processo de revisão. O score é um resultado de inferência, não uma garantia de que a transação é fraudulenta.
Como um modelo transforma uma requisição em um resultado?
Uma requisição de inferência é convertida para o formato que o modelo consegue processar, passa pelo modelo e é traduzida em um resultado pronto para a aplicação. As etapas exatas dependem do tipo de modelo, mas a operação central é um forward pass pelos seus parâmetros aprendidos.
- Receber e validar: A aplicação envia a entrada, como texto, features estruturadas ou uma imagem. A camada de serving verifica se a requisição é válida.
- Preparar a entrada: O pré-processamento pode normalizar valores, redimensionar uma imagem ou dividir o texto em tokens e mapear esses tokens para representações numéricas.
- Executar o modelo: O modelo realiza cálculos ao longo de suas camadas. Na inferência padrão, esses cálculos usam os pesos existentes em vez de alterá-los.
- Formatar o resultado: O sistema converte a saída do modelo em um score, classe, texto ou outro formato que a aplicação possa usar.
- Registrar e monitorar: Sistemas em produção acompanham a saúde do serviço e sinais de qualidade relevantes, respeitando as políticas de acesso e retenção de dados.
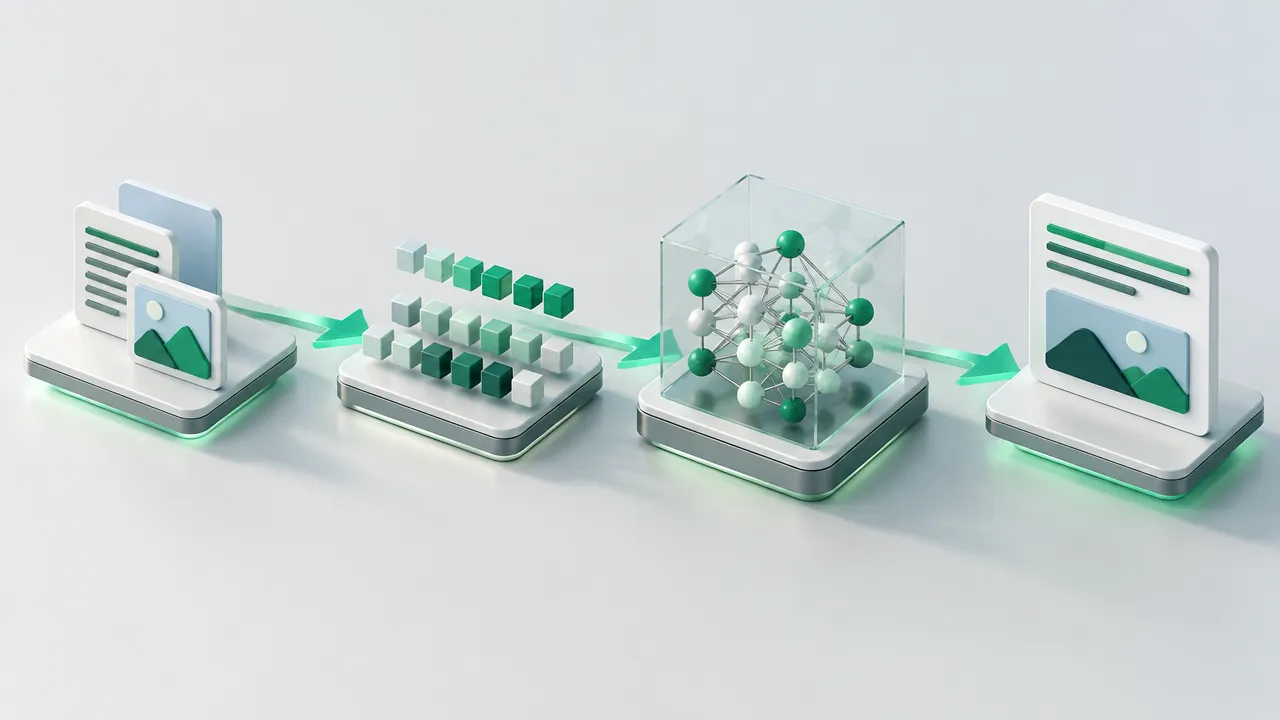
Essa etapa final na aplicação é importante. Um modelo pode retornar um resultado tecnicamente válido que ainda precisa de um limiar, uma verificação de política ou revisão humana antes de afetar um cliente ou uma transação.
Qual é a diferença entre inferência e treinamento?
O treinamento ajusta os parâmetros de um modelo usando dados e um processo de otimização; a inferência usa o modelo resultante para responder a novas requisições. O treinamento costuma ser uma atividade iterativa de desenvolvimento. A inferência é a execução repetida que acontece quando uma aplicação está em uso.
| Dimensão | Treinamento | Inferência |
|---|---|---|
| Objetivo | Aprender ou atualizar os parâmetros do modelo | Aplicar os parâmetros aprendidos a novas entradas |
| Padrão | Passagens repetidas sobre os dados de treinamento | Requisições individuais, em streaming ou em lote |
| Principais preocupações | Tempo de treinamento, dados, convergência e qualidade do modelo | Latência, throughput, disponibilidade, custo e qualidade dos resultados |
| Mudança típica | Os pesos podem ser atualizados | Os pesos normalmente permanecem fixos durante a requisição |
Essa distinção afeta o planejamento de infraestrutura. Uma equipe avaliando necessidades de treinamento versus serving pode constatar que as duas etapas usam cronogramas, padrões de capacidade e metas de desempenho diferentes. Algumas organizações também fazem fine-tuning de um modelo, que é uma atividade de treinamento, e depois fazem o deploy da versão resultante para inferência.
Que tipos de inferência os sistemas em produção usam?
A inferência pode ser organizada de acordo com quando as requisições chegam e onde o modelo é executado. O padrão certo depende de a tarefa precisar de resposta imediata, poder esperar por um lote ou precisar ser executada perto do dispositivo ou da fonte de dados.
| Padrão | Como funciona | Uso comum |
|---|---|---|
| Online | Processa as requisições à medida que as aplicações as enviam | Assistentes interativos, scoring de transações e consulta de documentos |
| Batch | Processa um conjunto de entradas de uma vez, geralmente de forma agendada | Classificação de back-office, relatórios ou enriquecimento de documentos |
| Streaming | Avalia um fluxo contínuo de eventos à medida que chegam | Monitoramento de eventos, dados de sensores e alertas quase em tempo real |
| Local ou edge | Executa em um dispositivo próximo ou em um ambiente controlado | Ambientes com pouca conectividade, necessidade de resposta local ou requisitos de localidade de dados |
Esses padrões podem coexistir. Um banco pode fazer o scoring de transações individuais online enquanto executa um job batch separado para categorizar registros mais antigos. Equipes avaliando inferência de IA local devem comparar a necessidade de baixa dependência de rede ou de processamento local com as limitações do dispositivo, o esforço operacional e os requisitos de atualização do modelo.
Como os modelos generativos lidam com a inferência?
A inferência de IA generativa produz conteúdo a partir de uma entrada, muitas vezes prevendo um token por vez. Em um modelo de linguagem, o sistema primeiro processa o prompt e depois gera uma continuação com base no prompt e nos tokens já produzidos.
Equipes de serving costumam distinguir entre prefill, que processa o prompt de entrada, e decode, que gera a resposta token por token. Essas fases podem impor demandas diferentes de computação e memória. Um artigo de pesquisa recente descreve esse comportamento em duas fases como uma fonte de contenção no serving de modelos em larga escala, o que ajuda a explicar por que o tamanho do prompt e o tamanho da resposta podem afetar o desempenho de formas diferentes. A pesquisa sobre cargas de trabalho de prefill e decode traz mais detalhes.
Inferência e raciocínio são termos relacionados, mas não intercambiáveis. Raciocínio descreve a tarefa ou o comportamento de um modelo, enquanto inferência é a execução que produz seu resultado. Da mesma forma, IA generativa se refere a uma categoria de modelos e aplicações, enquanto inferência é o processo que executa esses modelos.
No caso de um agente de IA, uma única requisição do usuário pode gerar várias chamadas ao modelo, chamadas a ferramentas e resultados intermediários. Isso faz do fluxo de trabalho completo, e não de uma única resposta, a unidade relevante para medir tempo e custo.
O que transforma um modelo em um serviço de produção?
Um serviço de inferência em produção conecta um modelo às aplicações por meio de um caminho de requisição confiável. Normalmente inclui uma API ou outra interface, validação de entrada, software de serving de modelos, recursos de computação, controles de acesso e monitoramento.
Um servidor de inferência aceita requisições e as encaminha para o runtime do modelo. Em uma aplicação bancária, esse servidor pode ficar atrás de uma API interna que autentica o serviço chamador, aplica limites de requisição e retorna um resultado estruturado. Separar o endpoint do modelo da lógica da aplicação pode facilitar a atualização de um modelo sem redesenhar todos os fluxos voltados ao usuário.
A orquestração de infraestrutura ajuda a alocar computação, reiniciar serviços com falha e gerenciar versões conforme a demanda muda. Equipes escolhendo uma plataforma de inferência de IA para cargas de trabalho bancárias devem avaliar como ela lida com deploy, observabilidade, acesso, suporte e os requisitos de localização de dados da organização, além da velocidade bruta do modelo.
A engenharia de inferência abrange esse trabalho operacional: empacotar modelos, configurar o serving, medir desempenho, controlar releases e responder a mudanças na demanda ou na qualidade dos resultados. Ela conecta o desenvolvimento do modelo às expectativas de nível de serviço da aplicação.
Como as equipes devem medir o desempenho da inferência?
Não existe um único número que indique se um sistema de inferência é rápido o suficiente. As equipes devem medir a experiência e a capacidade que importam para a carga de trabalho, verificando ao mesmo tempo se o modelo continua atingindo sua meta de qualidade.
- Latência: Quanto tempo uma requisição leva para receber um resultado. Em serviços generativos, as equipes costumam acompanhar o time to first token e o intervalo entre os tokens seguintes.
- Throughput: Quanto trabalho o sistema conclui ao longo do tempo, como requisições, registros ou tokens de saída.
- Concorrência: Como o desempenho muda quando várias requisições chegam ao mesmo tempo.
- Qualidade: Se os resultados continuam atendendo aos critérios de acurácia ou de avaliação específicos da tarefa.
- Confiabilidade: Com que frequência as requisições são bem-sucedidas e como o serviço se comporta em picos de carga ou falhas de componentes.
Benchmarks são úteis quando sua carga de trabalho se parece com o deploy pretendido. A MLCommons documenta benchmarks de inferência por tarefa e inclui detalhes como datasets, acurácia de referência e restrições de latência. As definições e os cenários dos benchmarks mostram por que as comparações devem considerar tanto a carga de trabalho testada quanto seus requisitos de qualidade.
Para um banco, a velocidade de um modelo no melhor cenário, com um prompt curto, pode não representar requisições que incluem longos históricos de clientes ou documentos recuperados. Um benchmark útil, portanto, reflete os tamanhos de entrada esperados, os limites de resposta, a concorrência e o atraso aceitável para a aplicação.
Quais escolhas de GPU e otimização afetam o serving?
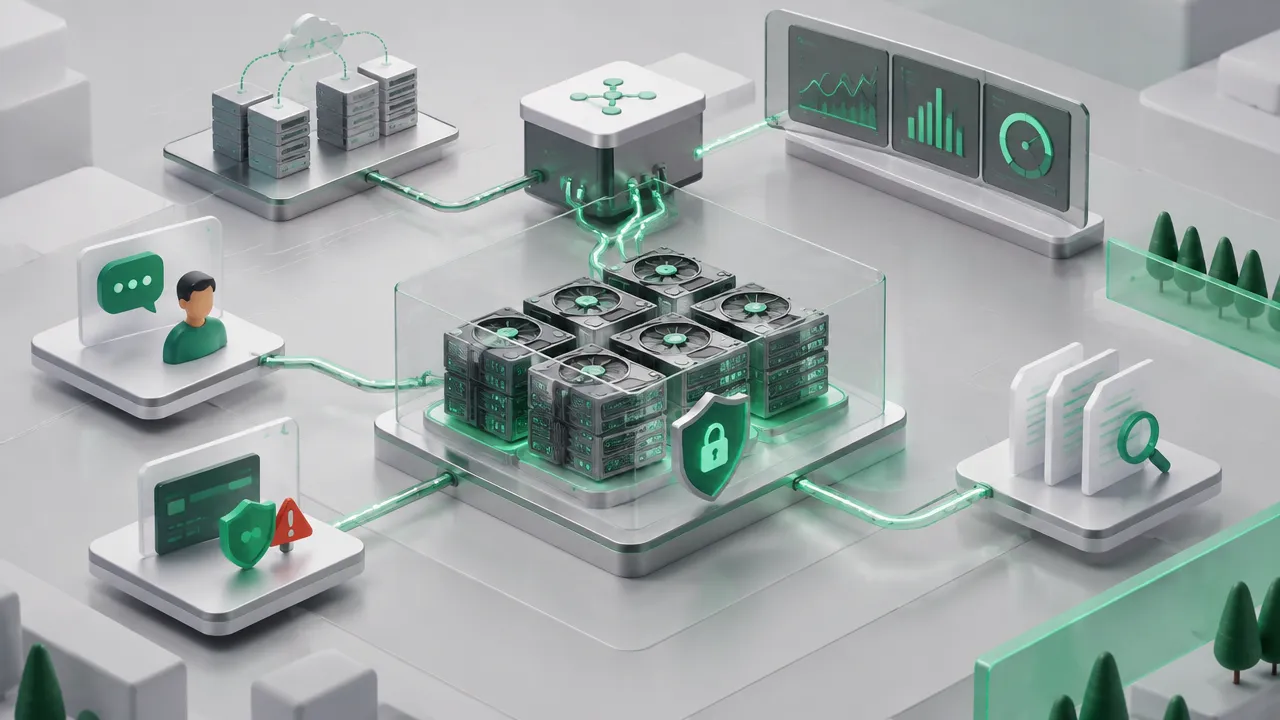
A escolha da GPU deve seguir o modelo, o padrão de requisições e a meta de serviço, e não apenas o nome do hardware. A capacidade de memória pode limitar quais tamanhos de modelo e de contexto cabem, enquanto a capacidade de computação e a largura de banda de memória afetam a rapidez com que as requisições são processadas.
Equipes escolhendo uma GPU para inferência devem testar o modelo pretendido com prompts, concorrência e configurações de precisão representativos. A quantização pode reduzir o uso de memória e melhorar o throughput, mas pode alterar a qualidade dos resultados, por isso cada configuração precisa ser validada em relação aos critérios de aceitação da aplicação.
Outros métodos de otimização incluem agrupar requisições em lotes, reutilizar dados em cache quando apropriado, controlar os tamanhos máximos de entrada e saída e separar cargas de trabalho com metas de serviço diferentes. A otimização deve ser medida de ponta a ponta, porque um runtime de modelo mais rápido pode não reduzir o tempo total de resposta se o pré-processamento, a rede ou as verificações posteriores forem predominantes.
O que determina os custos de inferência?
O custo de inferência depende de quanta computação uma carga de trabalho consome e de quão eficientemente o serviço a utiliza. O volume de requisições é apenas um fator: tamanho do modelo, tamanho do prompt e da saída, concorrência, capacidade ociosa e configuração de serving podem alterar o total.
O orçamento deve começar por um perfil de requisição representativo. As equipes podem estimar o volume diário esperado, a concorrência típica e de pico, o tamanho de entrada e saída e quanta capacidade precisa permanecer disponível em períodos de baixa demanda. Em seguida, devem medir o consumo real sob carga realista, em vez de se basear apenas na quantidade de parâmetros do modelo.
- Separe o tráfego interativo dos jobs que podem ser executados em lote.
- Acompanhe a utilização junto com o tempo de resposta e a qualidade dos resultados.
- Teste se o batching ou variantes menores do modelo atendem à meta de qualidade exigida.
- Inclua custos operacionais como armazenamento, rede, suporte e capacidade reservada para picos.
Equipes avaliando custos de inferência também devem examinar as unidades de cobrança e as tarifas de transferência de dados. Um modelo de GPU cobrado por hora pode facilitar a contabilização de experimentos de curta duração e de demanda variável, mas uma comparação de custos ainda precisa considerar a mesma carga de trabalho, a mesma meta de serviço e os mesmos serviços incluídos dos dois lados.
Onde entram privacidade, governança e localização dos dados?
A inferência pode expor informações sensíveis, porque as aplicações enviam dados reais para um ambiente de serving de modelos. Organizações reguladas devem definir quais dados entram em cada requisição, quem pode acessá-los, como são registrados em log, por quanto tempo são retidos e onde o processamento ocorre.
Manter a computação e os dados no Brasil pode ajudar as organizações a reduzir a movimentação internacional de dados e a alinhar as escolhas de infraestrutura com a governança interna e as obrigações da LGPD. A localização, por si só, não garante conformidade: controles de acesso, práticas de segurança, retenção, termos dos fornecedores e a finalidade da aplicação também importam.
O AI Risk Management Framework do NIST trata a gestão de riscos como relevante em todo o design, desenvolvimento, deploy, uso e avaliação de sistemas de IA. Suas orientações podem ajudar as equipes a estruturar revisões de governança e operacionais ao longo desse ciclo de vida. O framework de riscos de IA do NIST é uma orientação voluntária, e não substitui a análise jurídica nem os controles específicos de cada setor.
Algumas equipes exploram métodos de preservação de privacidade, como execução confidencial ou técnicas de conhecimento zero (zero-knowledge). Essas abordagens tratam de problemas técnicos diferentes e não devem ser vistas como garantias intercambiáveis. Uma avaliação de deploy deve explicitar o modelo de ameaças, as informações protegidas e quais evidências o método realmente pode fornecer.
Como a infraestrutura de GPU gerenciada apoia a inferência em produção?
A infraestrutura de GPU gerenciada pode reduzir o trabalho operacional envolvido no provisionamento de aceleradores, na orquestração de cargas de trabalho e na adaptação da capacidade à demanda. Ela é relevante quando as equipes precisam de serving com GPU, mas não querem construir e manter sozinhas todas as camadas do ambiente.
A Nuplia oferece GPU-as-a-Service gerenciado e infraestrutura soberana de inferência de IA no Brasil para organizações que executam cargas de trabalho de IA em produção. O serviço inclui capacidade elástica de GPUs NVIDIA com cobrança por hora, incluindo GPUs RTX PRO 6000 Blackwell para inferência e fine-tuning, com Kubernetes e orquestração de GPU.
Para organizações avaliando opções de deploy, a Nuplia também oferece suporte contratual em português, faturamento em BRL com NF-e e zero taxas de egress. Esses termos operacionais podem ser considerados junto com a adequação do modelo, os testes de latência, os requisitos de governança e o perfil real de custos da carga de trabalho.
A escolha adequada depende do serviço que está sendo construído. Um pequeno endpoint interno de classificação, um assistente conversacional de alta concorrência e um pipeline batch de documentos não precisam necessariamente da mesma configuração de GPU nem do mesmo modelo de operação.
O que as equipes devem validar antes do lançamento?
Uma revisão de prontidão para produção deve testar o modelo e o serviço em conjunto. Ela deve confirmar que as requisições esperadas produzem resultados aceitáveis na velocidade exigida, enquanto a infraestrutura e os controles de governança se comportam como previsto.
- Defina a tarefa, o impacto para o usuário e a qualidade aceitável dos resultados.
- Escolha processamento online, batch, streaming, local ou misto com base no fluxo de trabalho.
- Faça benchmarks com entradas, tamanhos de saída, concorrência e picos de demanda realistas.
- Meça latência, throughput, confiabilidade, utilização e custo sob as mesmas condições de teste.
- Estabeleça regras de acesso, logging, retenção e resposta a incidentes para os dados de produção.
- Defina como as equipes vão monitorar a qualidade, fazer rollback de um release e responder à degradação do serviço.
A inferência é o ponto em que a capacidade do modelo encontra a realidade operacional. Um modelo se torna útil em produção quando seus resultados atendem à tarefa e o sistema ao seu redor consegue entregá-los com desempenho previsível, controles auditáveis e um custo que a organização consegue sustentar.