Serviços gerenciados de GPU em nuvem fazem sentido no Brasil quando workloads de IA em produção precisam de capacidade dedicada de aceleradores, tratamento local de dados ou suporte operacional que um ambiente de uso geral não oferece com eficiência. Eles são especialmente relevantes para empresas reguladas com demanda variável, equipe limitada para operar GPUs ou requisitos claros de infraestrutura brasileira. A decisão deve se basear em medições do workload, análise do fluxo de dados e uma comparação completa de custos.
Pontos-chave para avaliar GPU gerenciada em nuvem
- Use capacidade de GPU gerenciada quando a demanda varia, a operação de GPUs exige esforço especializado ou a infraestrutura local é um requisito de negócio.
- Compare o custo total do workload, incluindo tempo ocioso, armazenamento, suporte, rede e egress, e não apenas o preço por hora de GPU.
- A localização dos dados no Brasil pode simplificar o controle sobre onde ficam a computação e os dados, mas, por si só, não garante conformidade com a LGPD.
- Conduza um piloto com metas mensuráveis de desempenho, confiabilidade, segurança e custo antes de migrar workloads de produção.
GPU gerenciada em nuvem se adapta a workloads com demanda variável ou especializada
Um serviço gerenciado é mais útil quando uma empresa precisa de capacidade de GPU sem comprar e operar uma frota fixa de servidores. Isso pode se aplicar a tráfego de inferência que varia ao longo do dia, projetos de fine-tuning de modelos ou equipes que precisam testar um workload de produção antes de se comprometer com capacidade de longo prazo.
Também pode atender equipes cujo parque de GPUs fica subutilizado entre jobs. Um serviço com capacidade elástica e cobrança por hora pode ajudar a alinhar melhor o uso da infraestrutura à demanda, desde que a empresa consiga iniciar e encerrar recursos com eficiência e considere eventuais mínimos ou capacidade reservada previstos em contrato.
Workloads comuns a avaliar incluem processamento de documentos, análise de fraude, modelos de atendimento ao cliente e funcionalidades de IA generativa. Fluxos de agentes de IA também podem precisar de inferência em GPU, mas seus requisitos completos de infraestrutura podem incluir bancos de dados, sistemas de recuperação, filas e monitoramento, e não apenas aceleradores.
A localização dos dados no Brasil importa quando atende a um requisito de controle definido
A infraestrutura local pode ser uma escolha prática quando uma organização precisa que workloads e dados permaneçam no Brasil dentro do seu modelo operacional. Isso pode ajudar a reduzir a movimentação internacional de dados e facilitar a definição de quem opera a infraestrutura, onde as informações são processadas e quais contratos regem o serviço.
No entanto, a residência de dados, sozinha, não é uma certificação de conformidade. O texto da LGPD estabelece requisitos para o tratamento de dados pessoais, enquanto as normas da ANPD tratam de transferências internacionais e das salvaguardas aplicáveis. A empresa deve avaliar, com suas equipes de privacidade e jurídico, a finalidade específica do tratamento, a base legal, os papéis de cada agente, os controles de segurança e os mecanismos de transferência.
A localização é especialmente relevante para bancos, fintechs e outras organizações que lidam com dados sensíveis ou regulados. A avaliação deve abranger não só o host de GPU, mas também backups, logs, acessos de suporte, artefatos de modelos, ferramentas de observabilidade e quaisquer serviços conectados que possam receber dados.
Compare o custo operacional total, não apenas o preço da GPU
O preço de GPU gerenciada fica mais fácil de avaliar quando a equipe mapeia seu workload da entrada à saída. A comparação deve incluir tempo de acelerador, armazenamento, movimentação de dados, operação da plataforma e todo o esforço da equipe necessário para manter os jobs disponíveis e monitorados.
- Utilização: estime as horas ativas de GPU e identifique períodos ociosos ou picos de demanda.
- Movimentação de dados: considere as transferências entre armazenamento, computação e serviços downstream.
- Operação: inclua configuração, aplicação de patches, orquestração, monitoramento e resposta a incidentes.
- Condições comerciais: revise unidades de cobrança, compromissos mínimos, cobranças de suporte e taxas de egress.
- Moeda e faturamento: verifique se a cobrança em moeda local e documentos fiscais brasileiros simplificam os processos financeiros.
Essa análise conecta o desenho da infraestrutura aos gastos com infraestrutura de IA. Um preço por hora baixo pode não ser a opção de menor custo se o workload exigir muito trabalho de engenharia ou gerar cobranças em outros pontos. Por outro lado, um ambiente gerenciado pode não compensar para um workload pequeno e estável que já roda com eficiência na infraestrutura existente.
A operação gerenciada tem valor quando a complexidade das GPUs atrasa as entregas
A infraestrutura de GPU envolve mais do que o hardware acelerador. Uma stack de infraestrutura de IA em produção também precisa de drivers e software compatíveis, agendamento de workloads, armazenamento, rede, controles de acesso, logging e procedimentos de recuperação. Se a equipe não tem capacidade para manter essas camadas, um serviço gerenciado pode reduzir a carga operacional e permitir que os engenheiros dediquem mais tempo a modelos e aplicações.
Esse benefício depende do escopo do serviço. Os compradores devem confirmar quem cuida do Kubernetes e da orquestração de GPUs, como a capacidade é alocada, o que o suporte cobre, como os incidentes são escalados e quais responsabilidades continuam com o cliente. O rótulo de gerenciado não garante que todas as camadas sejam operadas para o cliente.
Para um engenheiro de infraestrutura de IA, o serviço certo deve oferecer visibilidade suficiente para diagnosticar desempenho e controlar workloads, em vez de esconder configurações essenciais atrás de uma interface opaca. As equipes devem testar os fluxos de deploy, a observabilidade, as permissões de acesso e a rapidez com que o suporte ajuda a resolver um problema realista.
Um piloto curto pode mostrar se o workload é adequado
Um piloto representativo é mais útil do que um benchmark genérico porque testa o modelo, o caminho dos dados e as premissas operacionais em conjunto. As equipes devem escolher um workload delimitado e definir os critérios de sucesso antes de provisionar capacidade.
- Meça a latência, o throughput e a utilização de GPU de referência no ambiente atual.
- Use dados representativos e o modelo pretendido, incluindo as etapas de pré-processamento e pós-processamento.
- Teste o tráfego normal, os picos de demanda e a recuperação após a interrupção de um job ou serviço.
- Registre o custo de ponta a ponta, incluindo computação, armazenamento, movimentação de dados e suporte.
- Revise a localização dos dados, os controles de acesso, a retenção, o logging e as responsabilidades contratuais.
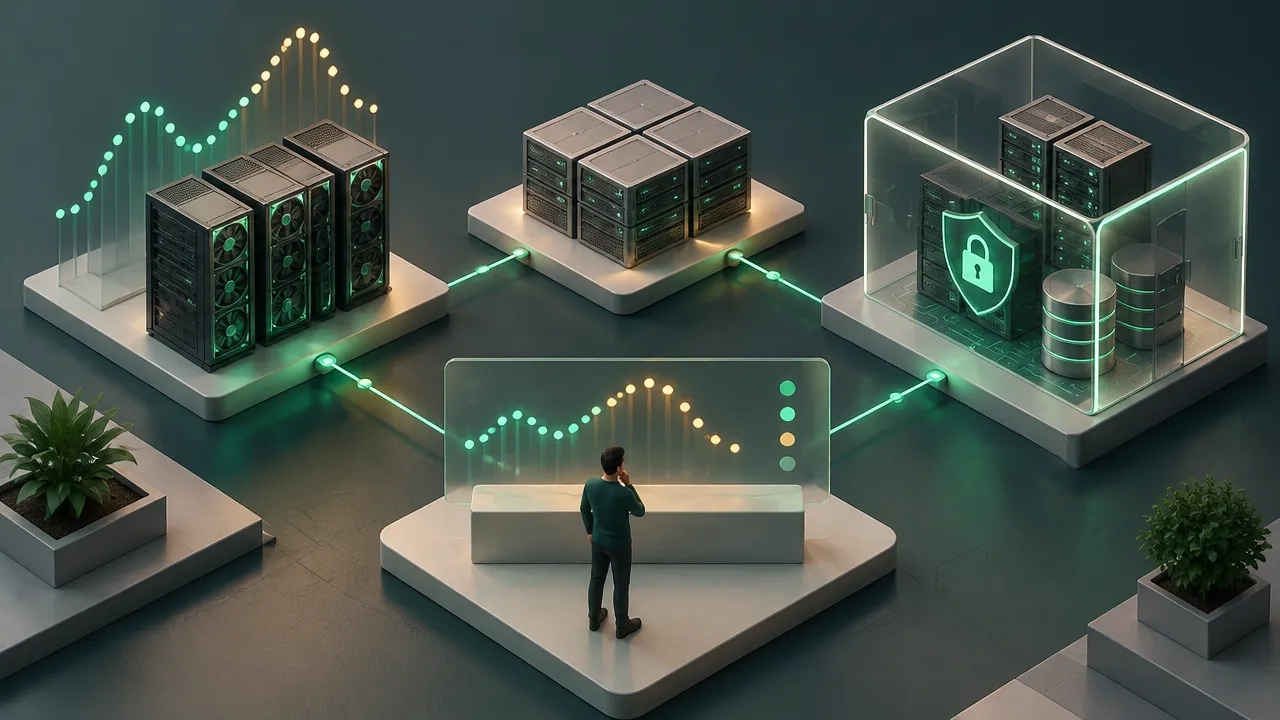
O piloto também deve confirmar se a plataforma suporta o caminho de deploy pretendido. Para workloads em Kubernetes, verifique se os manifests, o monitoramento e os processos de release existentes funcionam como esperado. Para inferência, teste os padrões reais de requisições e os objetivos de nível de serviço, e não apenas uma única execução offline do modelo.
A Nuplia atende equipes que precisam de capacidade de GPU gerenciada no Brasil
A Nuplia oferece GPU-as-a-Service gerenciado e infraestrutura soberana de inferência de IA no Brasil. Seu serviço inclui capacidade elástica de GPUs NVIDIA com cobrança por hora, incluindo GPUs RTX PRO 6000 Blackwell para inferência e fine-tuning, além de Kubernetes e orquestração de GPUs.
Para organizações brasileiras, a Nuplia também oferece computação e dados localizados no Brasil, suporte contratual em português, faturamento em BRL com NF-e e zero taxa de egress. Esses recursos podem ser relevantes para equipes que buscam operação local e maior previsibilidade na movimentação de dados e na cobrança. Ainda assim, cada organização deve validar seu próprio workload, seus requisitos de segurança e suas responsabilidades perante a LGPD.
A GPU gerenciada em nuvem é uma forte candidata quando infraestrutura local, acesso flexível a aceleradores e menor carga de operação de plataforma resolvem problemas concretos de negócio. Se a demanda é estável, os requisitos do workload são modestos ou o escopo do serviço não corresponde aos controles internos, outro modelo operacional pode ser mais adequado. Um piloto bem medido transforma essa escolha em uma decisão de infraestrutura baseada em evidências.